AI资讯新闻榜单内容搜索-Agent

AITNT-国内领先的一站式人工智能新闻资讯网站
# 热门搜索 #
搜索: Agent
本周 AI 项目推荐:Raindrop、AIUC、AIR Security……谁在做 Agent 的安全生意?

本周 AI 项目推荐:Raindrop、AIUC、AIR Security……谁在做 Agent 的安全生意?

本周 AI 项目推荐:Raindrop、AIUC、AIR Security……谁在做 Agent 的安全生意?

随着Agent执行权限外扩,Raindrop、AIR Security、Arcjet、腾讯AI-Infra-Guard、AIUC和Testudo六个项目分别从故障监控、供应链防护、执行前权限检查、开源漏洞扫描、认证审计和保险赔付等环节布局,形成Agent风险控制产业链。

来自主题: AI资讯
8414 点击    2026-09-20 15:12
YC 最新投资的 236 家公司:“几乎所有事情都不一样了”

YC 最新投资的 236 家公司:“几乎所有事情都不一样了”

YC 最新投资的 236 家公司:“几乎所有事情都不一样了”

YC 2026 夏季批次的 236 家公司中,91% 与 AI 相关,创业重心从应用层向算力、芯片、训练环境和物理世界显著下沉,Agent 已淡出主叙事,取而代之的是算力建设、推理成本优化、AI 原生服务公司和实体硬件的爆发式增长。

来自主题: AI资讯
10253 点击    2026-09-19 10:58
你每月花钱养的办公Agent,最后成了谁的资产?

你每月花钱养的办公Agent,最后成了谁的资产?

你每月花钱养的办公Agent,最后成了谁的资产?

文章指出当办公Agent深度介入工作后,用户面临工作方式主导权被平台锁定的风险,认为模型开源不等于Agent开源,Agent Runtime开源才是关键,并以DeepSeek发布的Harness和网易有道开源的LobsterAI(含OpenClaw)为例,说明开源Agent Runtime能为用户带来数据主权、可审计性、连续性和可定制性。

来自主题: AI技术研报
8931 点击    2026-09-19 10:58
GLM-5.3-FlashX 上线:200 tokens/s

GLM-5.3-FlashX 上线:200 tokens/s

GLM-5.3-FlashX 上线:200 tokens/s

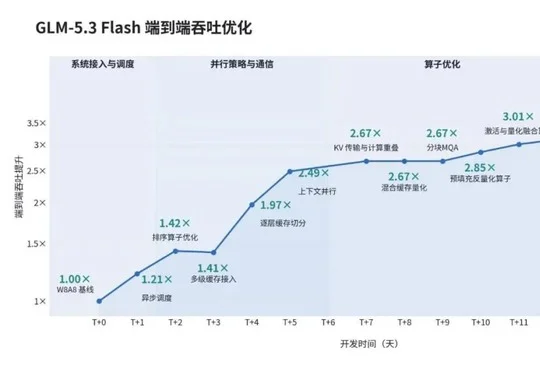
智谱上线 GLM-5.3-FlashX 模型,推理速度最高达 200 tokens/s,较 GLM-5.3-Flash 提速 5 倍、提价 2.5 倍,API 同步开放,该模型在 10 万张国产芯片提供的推理算力基础上,由 GLM-5.3 驱动 Agent 在两周内完成端到端构建并通过 Infra 侧优化将吞吐提升至初始基线的 3 倍。

来自主题: AI资讯
8467 点击    2026-09-18 15:49
刚刚,智谱首个 RSI 成果发布,10 万国产卡用 GLM 造 GLM

刚刚,智谱首个 RSI 成果发布,10 万国产卡用 GLM 造 GLM

刚刚,智谱首个 RSI 成果发布,10 万国产卡用 GLM 造 GLM

智谱首席科学家唐杰发布 GLM-5.3-Flash 推理系统优化成果,模型仅用两周在超 10 万颗国产 AI 加速器集群上完成生产部署,端到端吞吐提升 3.2 倍,并由 GLM-5.3 驱动的 Infra Agent 参与瓶颈分析与代码修改,标志着智谱首个 RSI(递归自我改进)早期形态的落地。

来自主题: AI资讯
9129 点击    2026-09-17 22:08
AI Agent安全不能只靠Prompt了:上海AI Lab探索Agent安全进化新范式

AI Agent安全不能只靠Prompt了:上海AI Lab探索Agent安全进化新范式

AI Agent安全不能只靠Prompt了:上海AI Lab探索Agent安全进化新范式

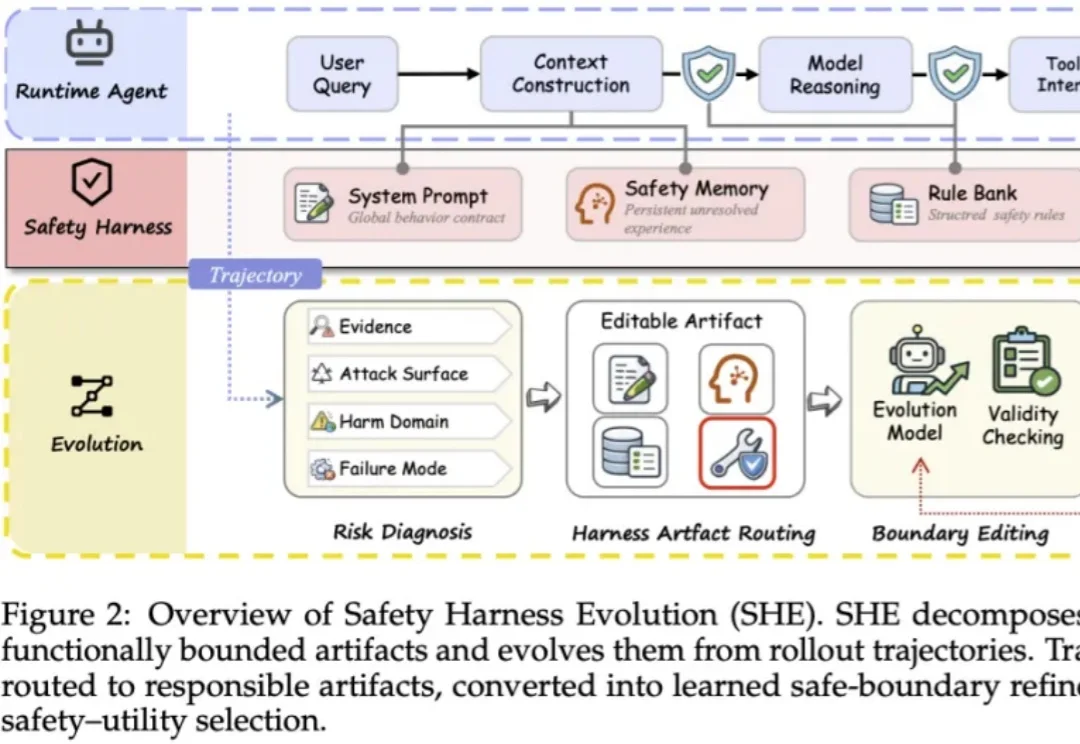
大模型 Agent 进入浏览器、邮件、数据库和业务系统后,安全评估如果仍只检查最终回复是否包含有害内容,覆盖面会明显不足。Agent 需要规划步骤、读取外部信息并调用工具,风险可能出现在执行过程中的任一环节。

来自主题: AI技术研报
6958 点击    2026-09-17 14:55
刚刚,全球首个开源Agent会话平台发布!老板、同事和我共享一个AI

刚刚,全球首个开源Agent会话平台发布!老板、同事和我共享一个AI

刚刚,全球首个开源Agent会话平台发布!老板、同事和我共享一个AI

当 AI Agent 开始连续数小时替人工作,真正有价值的就不只是最终成果,还有藏在会话(Session)里的整个过程:它做过什么、哪里失败、为何改变方向。

来自主题: AI资讯
6478 点击    2026-09-17 10:50
Meshy: 角色驱动下SPMD范式的RL训练框架

Meshy: 角色驱动下SPMD范式的RL训练框架

Meshy: 角色驱动下SPMD范式的RL训练框架

在过去的几年里,LLM RL 系统的工作负载发生了巨大的变化。早期的 RLHF 围绕同步训练展开:模型按固定顺序进行生成、打分和训练,每个阶段之间有着明确的同步边界。如今,系统还需要处理异步生成、持续训练、多轮 Agent 以及与外部环境的交互 —— 那些在同步执行中原本隐含的状态、版本和故障边界,现在都必须显式地进行管理。

来自主题: AI技术研报
10067 点击    2026-09-17 10:11
自进化社媒Agent!浙大x北大:从多模态任务编排到反馈驱动

自进化社媒Agent!浙大x北大:从多模态任务编排到反馈驱动

自进化社媒Agent!浙大x北大:从多模态任务编排到反馈驱动

当大模型已经能够快速生成文案、图片和视频,一个更进一步的问题是:Agent 能否从执行过的任务中积累经验,并在持续交互中改进后续行为?

来自主题: AI技术研报
9586 点击    2026-09-16 14:40
复杂的Harness Evolution,甚至不如多跑几遍

复杂的Harness Evolution,甚至不如多跑几遍

复杂的Harness Evolution,甚至不如多跑几遍

一个 Agent 第一次没把任务做对。

来自主题: AI技术研报
6466 点击    2026-09-16 14:40